DFKI-Forscher präsentieren mehr als 20 Beiträge auf der EMNLP 2026
| Sprache & Textverstehen | Preise & Auszeichnungen | Grundlagen der Systemischen KI | Interaktives Maschinelles Lernen | Speech and Language Technology | Sprachtechnologie und Multilingualität | Saarbrücken | Berlin | Darmstadt | Osnabrück / Oldenburg
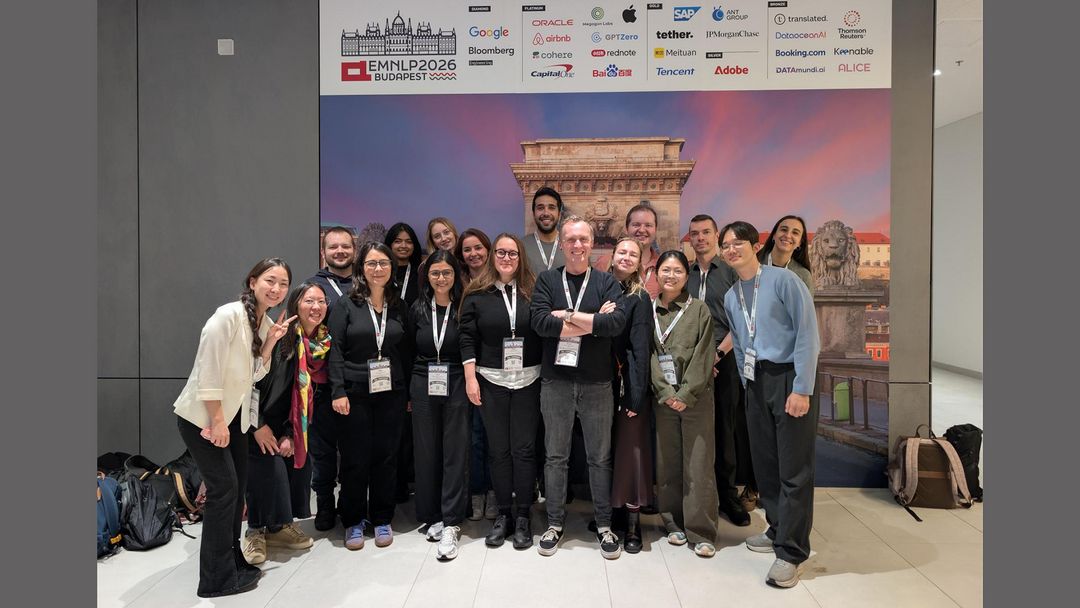
Die EMNLP wird jährlich von der Special Interest Group on Linguistic Data (SIGDAT) der Association for Computational Linguistics organisiert und zählt zu den weltweit führenden Konferenzen im Bereich der natürlichen Sprachverarbeitung. Das DFKI steuerte mehr als 20 Beiträge in den Bereichen Hauptkonferenz, Findings und Workshops bei. Die Beiträge stammten aus verschiedenen Forschungsbereichen und Partnergruppen, darunter Sprachtechnologie und Multilingualität (MLT), Speech and Language Technology (SLT), Interaktives Maschinelles Lernen (IML), Grundlagen der Systemischen KI (SAINT) sowie der XplaiNLP-Gruppe.
Das Verständnis von Sprachmodellen vorantreiben
Ein Schwerpunkt der Beiträge des DFKI lag auf den zunehmenden Bemühungen, zu verstehen, wie große Sprachmodelle (LLMs) Informationen verarbeiten und Ergebnisse generieren.
In einem der mündlichen Vorträge der Konferenz argumentierten DFKI-Forscher, dass die Tokenisierung der Ausgabe mehr bewirkt als nur die Darstellung von Text. Ihre Arbeit legt nahe, dass die Tokenisierung als implizite Form der Überwachung dient und maßgeblich beeinflusst, was Sprachmodelle letztendlich lernen.
Weitere Studien untersuchten, wie Modelle bei der Übersetzung syntaktische Strukturen von sprachspezifischen Informationen trennen, wie sie Schriftsysteme darstellen und auswählen und wie Aktivierungssteuerungstechniken mehrsprachige und verhaltensbezogene Attribute kombinieren können. Die Forscher zeigten zudem, dass Steuerungsmethoden die Generierung synthetischer Trainingsdaten für ressourcenarme Sprachen verbessern können.
Weitere Beiträge befassten sich mit Erklärbarkeit und Interpretierbarkeit in Sprachmodellen, darunter die Auswirkungen der Modellquantisierung auf Selbsterklärungen, mehrsprachige kontrafaktische Erklärungen, die Validität automatisierter Erklärbarkeitsmetriken sowie die Grenzen von LLM-basierten Simulatoren zur Bewertung von Erklärungen.
Untersuchung von Voreingenommenheit und Fairness
Ein weiterer wichtiger Forschungsbereich befasste sich mit Fairness und Voreingenommenheit in Sprachtechnologien. DFKI-Forscher analysierten, wie Stereotypen aus den internen Repräsentationen mehrsprachiger Modelle in den generierten Text übertragen werden. Andere Arbeiten zeigten, dass geschlechtsbezogene Hinweise in Eingabeaufforderungen sowohl die Qualität von KI-generiertem Code als auch die Bewertung der Ergebnisse beeinflussen können.
Weitere Studien deckten systematische Tendenzen bei der Bewertung politischer Aussagen durch LLMs auf und untersuchten, wie methodische Entscheidungen die Lokalisierung demografischer Verzerrungen in der klinischen Textgenerierung beeinflussen können. Zusammengenommen unterstreichen diese Beiträge die Bedeutung transparenter Bewertungsmethoden und einer auf Verzerrungen bedachten Modellentwicklung.
Neue Perspektiven zu Bewertung und Daten
Ein zweiter Vortrag, der im Rahmen des thematischen Schwerpunkts der Konferenz gehalten wurde, konzentrierte sich auf Bewertungsverfahren in der Forschung zur Generierung natürlicher Sprache im Zeitraum von 2020 bis 2025.
Die Forscher stellten außerdem FineWeb-CLaR vor, eine Ressource, die kulturelle, sprachliche und regionale Annotationen hinzufügt, um die Überprüfung großer Trainingskorpora zu unterstützen. Ein weiterer Beitrag präsentierte CHRONOBERG, einen Benchmark zur Untersuchung von Sprachwandel und zeitlichem Bewusstsein in Grundmodellen.
Weitere Arbeiten beleuchteten potenzielle Fallstricke bei der KI-Bewertung, indem sie zeigten, dass Formatierungsartefakte die scheinbare Leistung von Detektoren für KI-generierte Texte künstlich steigern können.
Vielfältige Anwendungen
Über die Grundlagenforschung hinaus demonstrierten die Beiträge des DFKI die praktische Anwendung von NLP-Technologien in verschiedenen Bereichen. Zu den auf der EMNLP 2026 vorgestellten Forschungsarbeiten gehörten die datenschutzkonforme Umformulierung klinischer Texte, Untersuchungen zur Faktengenauigkeit nach domänenspezifischem Fine-Tuning, längengesteuerte Zusammenfassung unter Verwendung von Diffusionsmodellen, Ansätze des verstärkenden Lernens zur Ereignisextraktion sowie Analysen von Desinformationsnarrativen und Überzeugungsstrategien in ukrainischen Memes.
Aufbau vertrauenswürdiger und mehrsprachiger KI
Ein deutlicher Trend, der sich auf der diesjährigen EMNLP abzeichnet, ist die wachsende Bedeutung des Verständnisses dafür, wie Sprachmodelle ihre Ergebnisse erzeugen. Da KI-Systeme immer leistungsfähiger werden und in großem Umfang eingesetzt werden, werden Interpretierbarkeit, Bewertung und Fairness zu zentralen Herausforderungen für die Forschungsgemeinschaft.
Die Beiträge des DFKI spiegeln diesen Trend wider, indem sie Forschung zu Interpretierbarkeit, Mehrsprachigkeit, Bewertung und Anwendungen in der Praxis integrieren. Über Projekte und Forschungsgruppen hinweg bleibt ein gemeinsames Ziel bestehen: die Entwicklung von Sprachtechnologien, die sprach-, kultur- und domänenübergreifend zuverlässig, transparent und fair funktionieren.
Kontakt:
Dr. Simon Ostermann
Stellv. Leiter FB Sprachtechnologie und Multilingualität, DFKI
- Simon.Ostermann@dfki.de
- Tel.: +49 681 85775 5310